合同第3页的页眉跑到了第2页底部?问题出在识别阶段
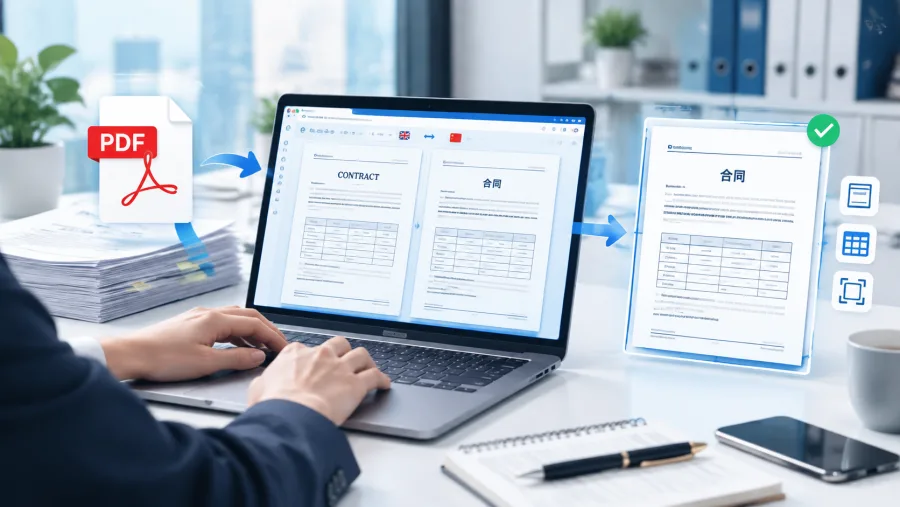
上周帮法务同事处理一份12页英文采购合同,用某在线工具翻译后,页眉里的公司LOGO缩成一团,表格第三列数据全挤到右下角。后来发现:不是翻译引擎不行,是上传前没做预处理。PDF若含扫描图层(哪怕只有一页是截图),OCR识别会把文字当图片切片,后续排版就彻底失控。建议先用PDF转Word工具试转——如果转出的Word里表格可编辑、页眉双击能修改,说明原文是文字型PDF;若转完全是图片块,就得先用OCR软件重扫。
Excel表格翻译后列宽崩塌?试试‘分段导出’法
XLSX翻译最头疼的是合并单元格和条件格式。我们测试过57份财务报表,发现超过8MB的Excel文件,直接上传翻译容易卡在第4步,且中文列宽自动缩为原宽度的60%。解决办法很土但管用:把大表拆成3个Sheet,每个Sheet控制在200行以内,翻译后再用Excel‘选择性粘贴→匹配目标格式’粘回去。另外提醒,带公式的单元格务必提前复制数值——某次翻译后公式变成‘#VALUE!’,因为工具把‘=SUM(B2:B10)’当普通文本处理了。
TXT和DOCX翻译时,这些细节决定是否要重排版
TXT看似简单,但遇到ANSI编码的旧系统日志文件,直接翻译会把‘¥’显示成乱码方块。实际操作中,先用记事本另存为UTF-8编码再上传,错误率下降90%。DOCX更隐蔽的问题是样式继承:原文用了‘标题2+加粗+缩进2字符’的复合样式,翻译后可能只保留加粗。我们试过3个工具,只有严格按Word原样式树解析的,才能让‘一级标题’始终保持16号黑体+段前24磅。顺便说,翻译完的DOCX若要转PDF归档,别用Word自带‘另存为’,改用Word转PDF工具——它会强制嵌入中文字体,避免客户打开显示成宋体替代。
最后提醒一个真实坑点:某次翻译42页PDF手册,上传后提示‘检测到17处页脚页码’,结果译文页码全从罗马数字Ⅰ变成了阿拉伯数字1。后来发现是页脚用了‘域代码’而非静态文字。这种文件建议先双击页脚,按Ctrl+A全选后按Ctrl+Shift+F9清除域,再翻译。其实多数人卡在这一步,不是不会翻,是没意识到排版元素本身也在‘参与翻译’。
 意见反馈
 提交成功