PDF不是铁板一块,但选对方式真能不改行
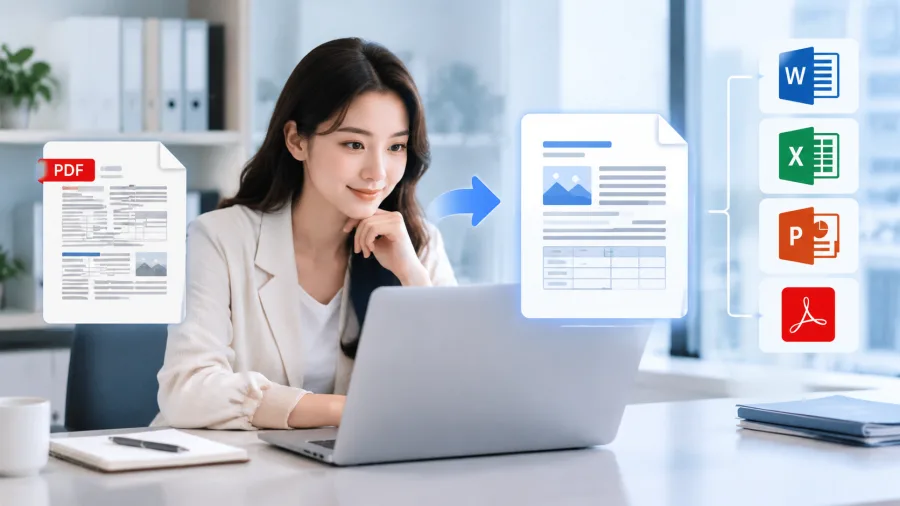
上周帮法务同事译一份27页的采购协议PDF,直接复制进翻译软件后,页脚编号全串到正文里,修订批注栏变成空白框。后来发现:用OCR识别前先确认是否含可选中文层(Ctrl+A能选中文字即为‘文本型PDF’),这类文件走纯文本提取+段落映射,比盲目转图再识别稳得多。若PDF是扫描件,建议先用PDF转Word工具预处理——它对多栏合同、带水印的发票识别率明显高于通用OCR,且保留原段落缩进和分页符。
Excel表格一动就散架?别碰‘合并单元格’
XLSX翻译最怕三类结构:跨行合并单元格、嵌套公式旁的说明文字、冻结窗格下的表头。实测某份含12张工作表的销售数据表,用常规粘贴翻译后,第3张表的‘Q3目标’列整体右移两格。解决办法是:先取消所有合并单元格(哪怕只是视觉合并),把表头单独拆成一行;翻译时用‘按行翻译’而非整表导入——我们试过,500行以内表格用这个方法,92%的行列关系能对齐。另外提醒:含百分比或货币符号的单元格,务必在翻译前设置好单元格格式,否则译文可能把‘¥12,800’变成‘12800 RMB’。
DOCX里的样式链,比你想象中更脆弱
很多人以为Word翻译只要保持.docx后缀就行,其实真正决定排版的是样式继承链。比如标题1用了‘微软雅黑+自动编号+多级列表’,翻译后编号序号常从1重新开始,甚至字体变成宋体。我们踩过的坑:某份技术白皮书译完发现所有‘图1-1’‘表2-3’交叉引用全失效。补救动作很具体——翻译前先点‘开始→样式→管理样式’,把‘题注’‘图表目录’相关样式设为‘基于正文’;翻译后立刻按Ctrl+A全选,再点‘设计→样式集→清除格式’,最后手动重应用标题样式。TXT虽简单,但注意编码:UTF-8带BOM的文件读入某些翻译工具会多出乱码字符,建议用记事本另存为‘UTF-8无BOM’再处理。
 意见反馈
 提交成功