字体没嵌进PDF里,Word就只能瞎猜
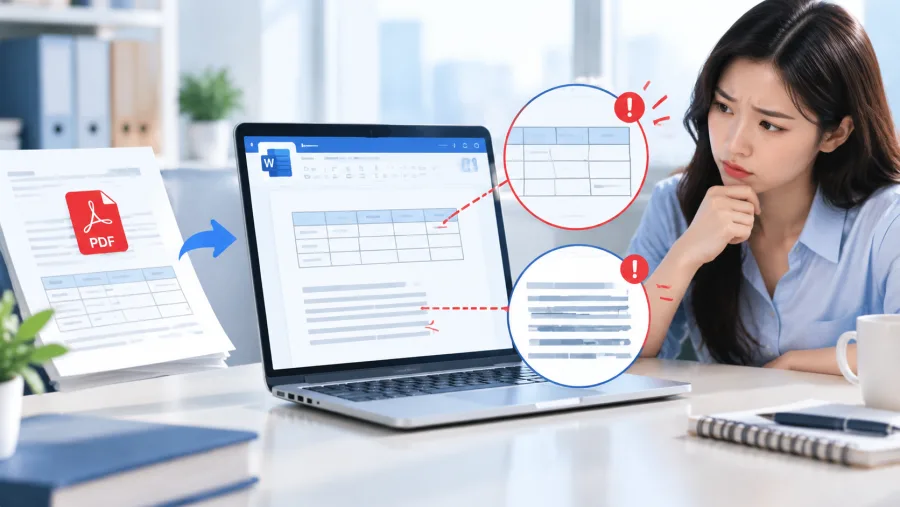
上周帮同事改一份投标书,他把客户发来的PDF转成Word后,所有标题都变成宋体五号——原PDF用的是思源黑体Medium,但导出时没勾选‘嵌入字体’。Word打开时找不到对应字重,自动降级为系统默认字体,字号、行距全乱。这类问题在20MB以内的合同类PDF中特别常见,尤其带公章扫描页的混合文档。解决方法很简单:转之前用Adobe Acrobat或福昕点开‘文件→属性→字体’,看列表里有没有标‘(Embedded Subset)’。没有?别急着转,先用我们免费的PDF转Word工具,它会自动检测并提示字体风险,还能保留原始字号层级。
扫描件不是‘图’,是‘看不见的字’
财务部小张传来的报销单PDF,表面看是清晰图片,实际是150dpi灰度扫描件。直接拖进在线转换器,结果生成的Word里文字全堆在左上角,表格线消失,金额列错位。原因很实在:OCR引擎没触发,或者触发了但没选对语言(她那份是中英混排,却只开了中文识别)。我们试过十几款工具,发现分辨率低于200dpi的扫描件,必须手动开启‘高精度OCR’且勾选‘英文+中文’双语识别。如果转完还是乱,别删重来,先把Word里乱码段落全选→‘开始→字体→隐藏文字’关掉,常有意外收获。
三栏新闻稿一转就变单栏流水账
市场部同事发来的行业简报PDF,排版是典型的三栏+侧边注释框。转完发现注释框飞到正文末尾,栏宽全崩。这不是转换器偷懒,而是PDF本身没存‘栏结构’元数据——它只是把文字按坐标硬贴在页面上。这时候不能靠重转,得人工干预:在Word里选中整篇内容→‘布局→栏→三栏’,再把侧边注释单独复制进文本框,用‘环绕方式→四周型’固定位置。如果原文档有分节符(比如每页底部带页码横线),记得在Word里打开‘开始→显示/隐藏编辑标记’,把多余的分节符删干净,否则栏宽会突兀跳变。另外提醒一句:超过50页、含大量矢量图的PDF,建议先用PDF压缩工具压到30MB以内再转,大文件容易卡在第17页突然中断,重试三次大概率还是停在同一页。
 意见反馈
 提交成功