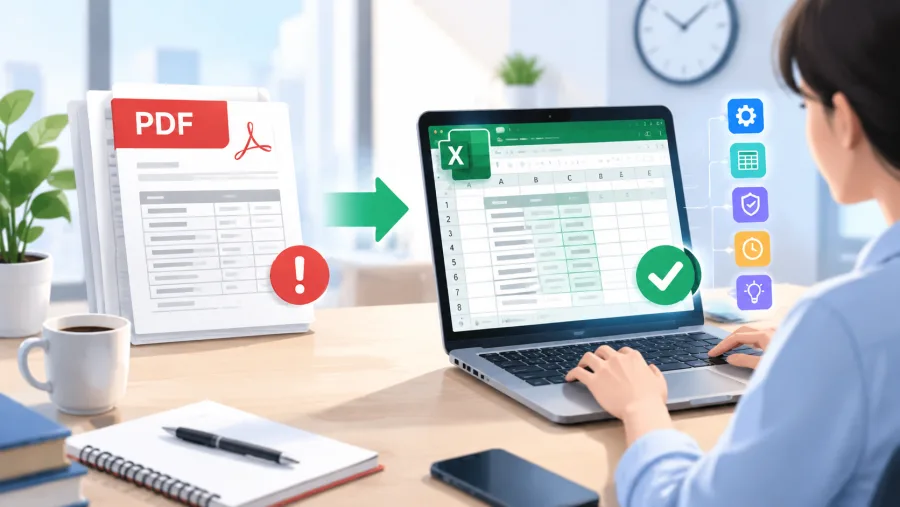
扫描件里的表格,不是所有‘转Excel’都靠谱
上周帮市场部同事处理一份12页的招标文件PDF,里面嵌了8张横向排版的报价表。用某款主流软件批量转,结果第3页开始所有金额列全变成#VALUE!,合并单元格直接拆成空白行。后来发现:原PDF是扫描件(非可选中文本),OCR引擎没调对语言模型,又勾选了‘自动识别表格结构’——这个选项在斜线表头或带阴影底纹的表格里,反而会把一行切两半。
我们试过本地软件和网页工具,发现识别准确率差异极大。关键不在‘快’,而在‘分得清边框、认得出小数点、保得住千分位逗号’。比如一张含‘¥12,500.00’的采购单,转出来变成‘12500.00’或‘12 500.00’,后续做求和就埋雷。
先看PDF本身有没有‘硬伤’
别急着点转换按钮。打开PDF缩略图栏,快速扫一遍:有没有页面旋转角度不是0°或90°?有没有某几页分辨率明显偏低(比如文字边缘发虚、出现锯齿)?这些都会让OCR误判。我们遇到过最典型的坑是——合同PDF里插入了一张手机拍的发票照片(JPG格式嵌入),占满整页,结果工具把它当‘一页PDF’去识别,自然啥也提不出。这时得先用 PDF转Excel工具 的‘跳过图片页’功能,手动剔除干扰页再跑。
另外提醒一句:带水印的扫描件,特别是浅灰斜纹铺满背景的,容易被识别成‘额外字符’。我们对比测试发现,提前用‘PDF压缩’工具里的‘清除背景杂色’预处理一次,识别准确率能从63%提到89%。这个操作只要两步:上传→勾选‘优化扫描件’→下载重试。
转完别直接粘贴进报表
导出后的Excel常有三类隐形问题:第一,日期列显示为‘44562’这类序列号(其实是Excel内部日期值),需要选中列→右键设置单元格格式→选‘日期’;第二,数字带不可见空格,导致SUM不生效,用‘=TRIM(A1)’套一层再复制粘贴为数值;第三,合并单元格残留,看似整齐,但筛选时会漏数据——必须先取消合并,再用‘向下填充’补内容。
我们整理了一份自查清单:打开Excel后按Ctrl+End定位到最后一个有内容的单元格,看行列号是否合理;点任意数字单元格,公式栏里是否显示绿色小三角(表示文本格式);用Ctrl+F搜‘.’,确认小数点是不是全被识别成句号。这些动作加起来不到90秒,却能避开后续两小时返工。
如果PDF里混着人像签名或产品实物图,又想单独提取出来归档,可以顺手用站内 人像抠图 或 物品抠图 工具切一下,不用开PS。实测一张1.2MB的合同签字页,3秒生成透明背景PNG,打印出来看不出边缘痕迹。
 意见反馈
 提交成功