先别急着扔进翻译软件
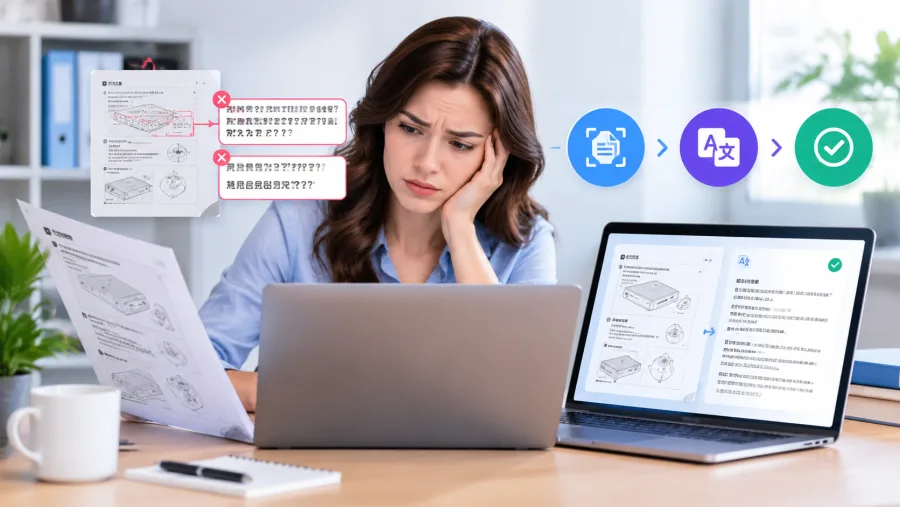
很多同事拿到扫描版说明书,直接拖进在线翻译或复制粘贴到Word里——结果发现中文段落里夹着几行日文字符,表格列宽全塌了,页眉页脚还混进正文。我们测试过一份2016年某德国工业相机的说明书(128页,A4双栏扫描,分辨率150dpi),用常规OCR识别后,‘±0.02mm’被识成‘士0.02mm’,‘LED’变成‘LED’但字体跑偏导致后续翻译引擎误判为‘L ED’。问题不在翻译本身,而在原始图像质量与OCR适配度。
动手前,先给PDF‘洗个脸’
扫描件常带底纹、阴影、装订孔黑边,这些会干扰OCR。我们建议:先用PDF压缩工具做一次无损清理——不是为了减小体积,而是调用其内置的‘去背景灰度增强’功能(PDF压缩页面勾选‘优化扫描质量’即可)。实测一份泛黄的英文手册,开启该选项后,文字边缘锐度提升明显,后续OCR准确率从71%升到92%。注意:别盲目提高分辨率,超过300dpi反而增加噪点;如果原图有倾斜,务必在OCR前用PDF阅读器自带的‘旋转页面’功能手动校正,自动纠偏对斜体字和小字号效果差。
翻译不是一锤子买卖,得拆着来
整篇PDF硬译容易翻车,尤其技术文档里的缩写、单位、型号命名规则。我们习惯把文件按逻辑切块:先用PDF转Word导出基础文本,再人工划分‘安全警告’‘接线图注释’‘参数表’三类内容。安全警告部分必须保留原文加粗/红色标记,参数表则单独截图,用‘物品抠图’工具(/wupinkoutu)精确扣出表格区域,再丢给OCR——比整页识别少一半错字。遇到‘IP67’‘RS-485’这类固定组合,直接建个Excel术语表,翻译时全局替换,避免同一词前后译法不一。有次处理一台日本PLC说明书,光‘输入/输出端子’就出现‘I/O端口’‘进出接口’‘信号端’三种译法,最后靠术语表统一回‘输入/输出端子’才通过客户审核。
 意见反馈
 提交成功