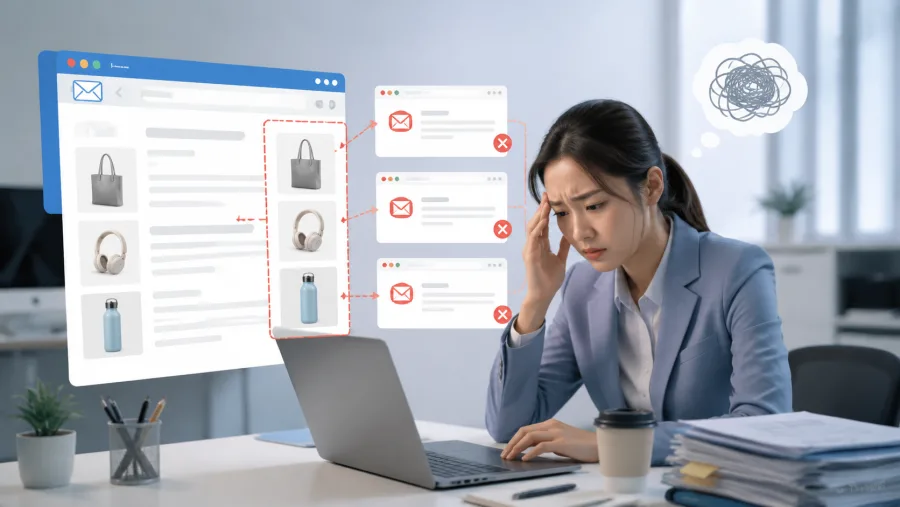
别只盯着邮件正文,客户第一眼扫的是图里的字
上周帮一位做LED灯配件的同事改邮件,她把英文说明书PDF直接转成Word再翻译,结果客户回信说‘第3页包装图上‘CAUTION’旁边那行小字怎么还是英文?’——原来PDF里是带底纹的斜体标签,PDF转Word时没识别出这行字,直接丢掉了。这类问题在10MB以下的扫描件PDF里尤其多,尤其是用手机拍的样品图,分辨率一低,OCR引擎就‘睁眼瞎’。
更麻烦的是产品图上的中英混排。比如一个电饭煲操作面板截图,英文按钮旁手写中文备注‘此处贴防伪标’,翻译时得把中文备注也译成英文,还得保持和原图位置一致。这时候光靠文字翻译工具不够,得先用物品抠图把按钮区域单独切出来,加蒙版重做标注,不然客户打开图发现中文备注突兀地留在英文界面里,信任感立马打折。
PDF附件里的表格图,千万别信‘自动识别’
有位做汽配的客户发来报价单,是Excel导出的PDF,但关键价格表用了截图插入——因为原表设置了保护,无法复制。我们用常规OCR工具识别,结果‘$24.80’被认成‘$24.00’,差的那8毛钱让整单谈判卡了两天。后来发现,这类带阴影边框的表格截图,必须先用图片格式转换把PDF转成PNG,再调高DPI到300,最后用专业OCR软件逐格校对。顺便提醒:PDF压缩工具慎用,PDF压缩后若开启‘图像降质’选项,截图文字边缘会糊,识别率直降40%。
客户要的不是双语对照,是‘看不见翻译痕迹’
真实案例:宁波一家纺织厂给意大利客户发新季色卡,邮件正文译得挺顺,但附件里JPG色卡图右下角印着‘Approved by QC Dept.’,翻译时只改了正文,忘了图上这行。客户回复:‘你们QC部门批准的是哪个版本?我收到的图没日期也没签名。’——其实他们习惯在图上加水印式批注,而我们只处理了独立文本块。解决办法是:所有含文字的图,先统一用人像抠图(它对文字边缘识别比通用工具稳)提纯背景,再用PS或在线工具覆盖翻译层,字号、颜色、间距全按原图像素级对齐。别嫌麻烦,客户打开邮件点开图,0.5秒内没发现文字是译过的,才是真过关。
 意见反馈
 提交成功